Dispositivos médicos · Identificação administrativa · Português
Quando o nome comercial não identifica um único cadastro na Anvisa
Auditoria de 100.681 IDs em uma exportação Anvisa: 11.253 compartilham nome comercial literal. Tabelas, gráficos e método; não mede produtos físicos ou segurança.
Fonte: Anvisa, exportação com HTTP Last-Modified 13/10/2026. 100.681 IDs presentes no arquivo; nomes e números administrativos não medem modelos físicos, segurança ou situação atual.
Dados públicos · Dispositivos médicos · Identificação administrativa
Um mesmo nome comercial pode aparecer associado a mais de um número de registro ou cadastro. Em uma exportação nacional da Anvisa com 100.681 identificadores distintos, encontramos 11.253 IDs com um nome comercial literal compartilhado por pelo menos dois IDs: 11,18% do total, como limite inferior confirmado. O resultado ajuda a entender por que guardar o número de identificação importa. Não é uma contagem de produtos físicos diferentes, nem uma medida de segurança.
Análise secundária de um arquivo administrativo público, com conferência dos cálculos. Não houve revisão médica ou por pares. A exportação foi obtida em 1º de novembro de 2026 e tinha cabeçalho HTTP Last-Modified de 13 de outubro de 2026. Isso identifica a edição do arquivo; não certifica a situação regulatória atual de cada registro. O catálogo inclui dispositivos de várias áreas, não apenas cirurgia plástica.
O que a análise encontrou
- 11.253 de 100.681 IDs — 11,18%. Esses identificadores participam de grupos com o mesmo nome comercial literal. É o resultado principal e um limite inferior confirmado, porque há nomes que não interpretamos.
- 4.372 de 93.740 nomes — 4,66%. Essa é a proporção de nomes comerciais literais conhecidos associados a pelo menos dois IDs. O denominador aqui é nome distinto, não número de cadastro.
- 9.813 de 100.572 associações — 9,76%. Mesmo ao combinar nome comercial e nome técnico literais, ainda há compartilhamento no conjunto completo usado nessa comparação.
- 60 IDs com nome comercial desconhecido para esta análise. Não tentamos adivinhar caracteres, remover aspas ou completar nomes a partir de outras linhas. Esses IDs continuam no denominador geral.
A pergunta é específica: o mesmo texto de nome comercial identifica sempre um único número dentro desse arquivo? A resposta é não. Isso não demonstra erro de cadastro, falsificação, duplicação indevida ou dano ao paciente. Demonstra que o nome, usado sozinho como chave administrativa, não é sempre exclusivo.
O próprio conceito de registro exige cuidado. A orientação oficial sobre registro, na pergunta 3, admite um produto ou uma família com vários modelos em um processo. Além disso, uma resposta da Anvisa no webinar de UDI de 17 de fevereiro de 2022, página 15, admite o mesmo UDI-DI em registros diferentes. Portanto, números distintos também não provam que existam produtos físicos distintos.
Por que 4,66% dos nomes e 11,18% dos IDs são respostas diferentes
Um nome que aparece em cinco números conta uma vez quando a unidade é nome distinto e cinco vezes quando a unidade é ID associado a esse nome. Misturar essas unidades produz uma estatística sem significado claro. Por isso, apresentamos as duas perguntas separadamente e mantemos seus denominadores visíveis.
Identificamos 93.740 nomes comerciais literais conhecidos vinculados a 100.621 IDs. Desses nomes, 89.368 apareciam em um único ID e 4.372 apareciam em dois ou mais. Os grupos compartilhados reuniam 11.253 IDs distintos. Como todos os 100.681 IDs do arquivo permanecem no denominador geral, incluindo os 60 com nome desconhecido para o método, a proporção confirmada é 11,18%.
| IDs por nome literal | Nomes distintos | Associações ID–nome |
|---|---|---|
| 1 | 89.368 | 89.368 |
| 2 | 3.240 | 6.480 |
| 3 | 619 | 1.857 |
| 4 | 244 | 976 |
| 5 ou mais | 269 | 1.940 |
| Total conhecido | 93.740 | 100.621 |
Entre os 4.372 nomes compartilhados, o grupo mais frequente é o de nomes vinculados a dois IDs: são 3.240 nomes. Há também 269 nomes vinculados a cinco ou mais números. A última faixa soma 1.940 associações, e não 269 multiplicadas por cinco: ela contém quantidades variadas, todas a partir de cinco.

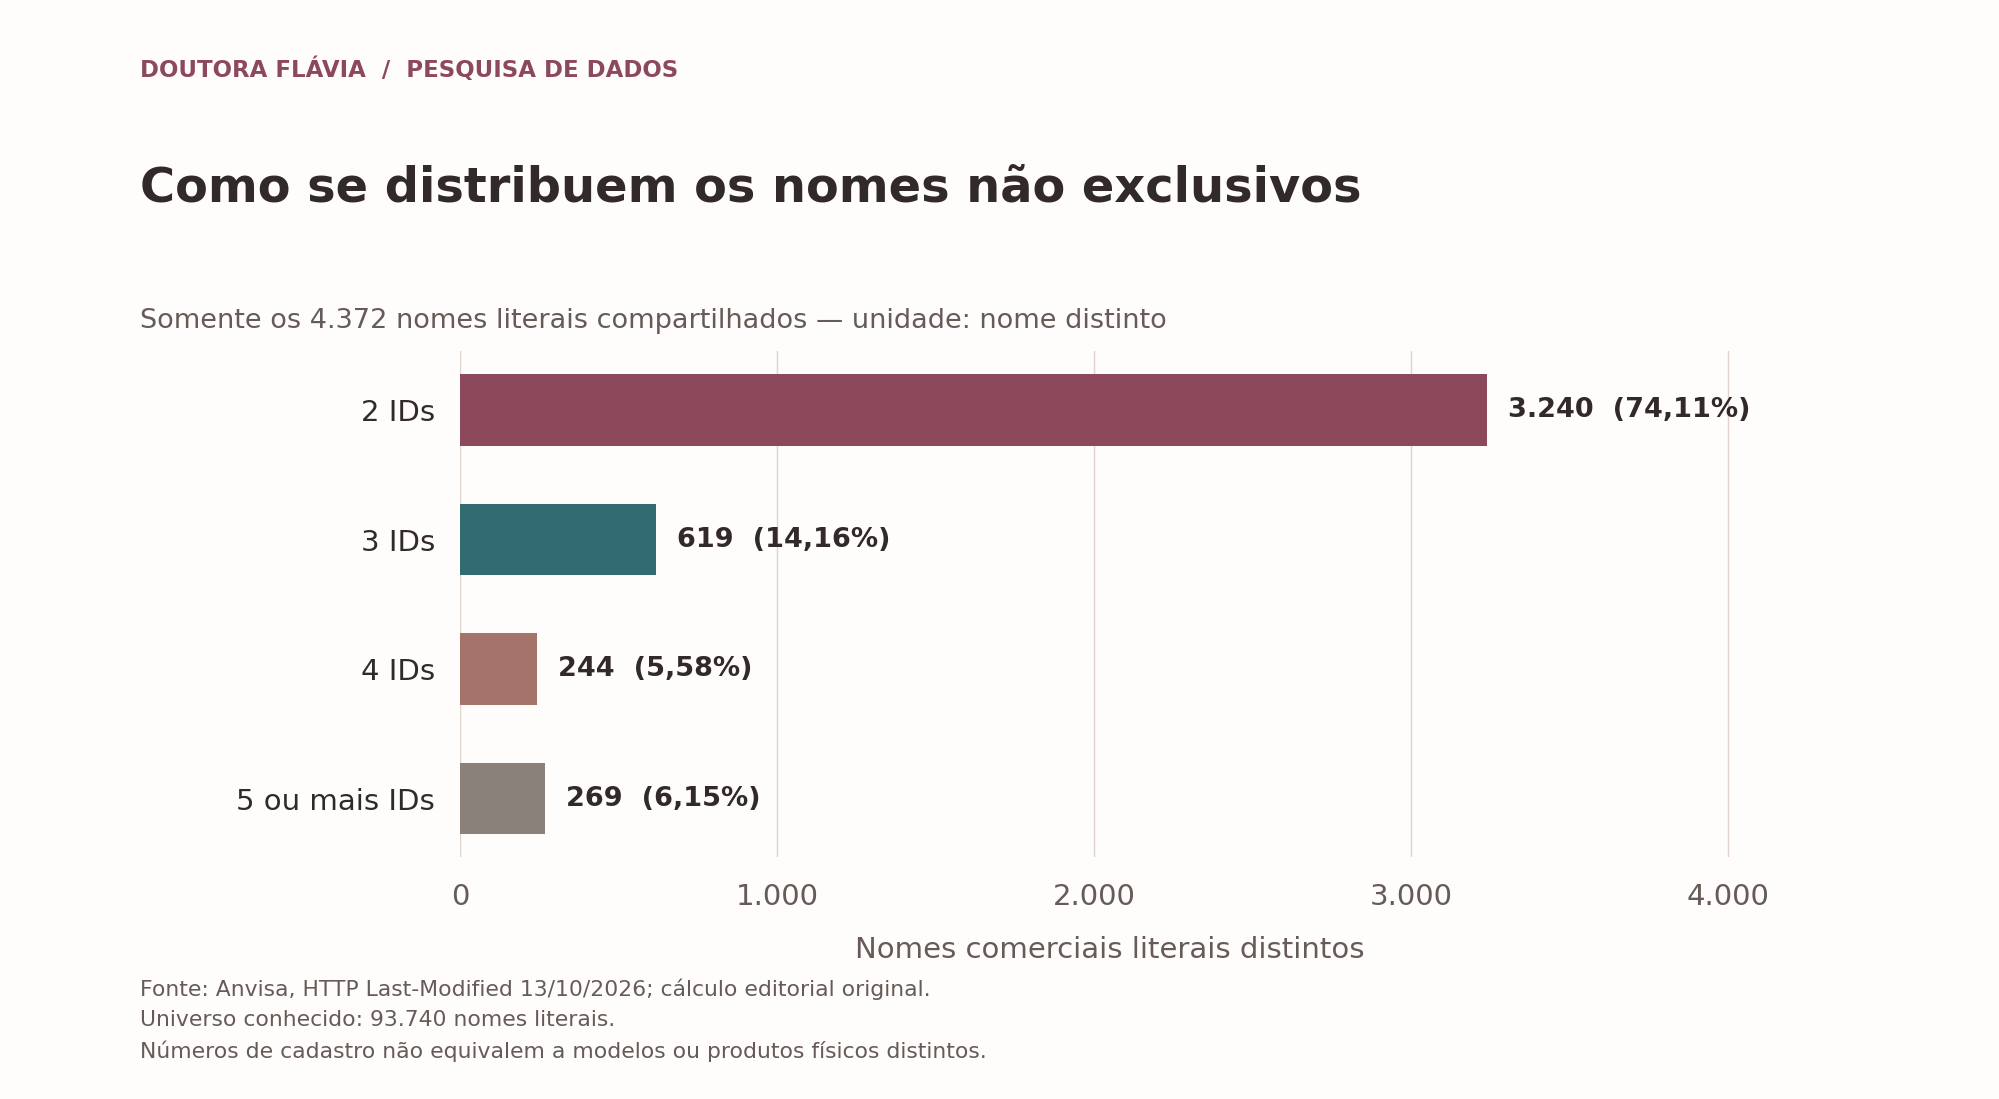
Essa concentração explica por que uma parcela relativamente menor de nomes envolve uma parcela maior de IDs. Não medimos quantas vezes esses nomes são procurados, quantas pessoas os conhecem, nem quantos dispositivos foram vendidos ou utilizados.
O que muda ao uniformizar espaços e maiúsculas
O resultado principal exige igualdade literal do texto interpretável. Preservamos letras, acentos, sinais, números e espaços. Em uma análise secundária, aplicamos uma convenção simples e declarada: normalização Unicode NFC, remoção de espaços nas extremidades, redução de sequências de espaços a um espaço e comparação sem distinção de maiúsculas e minúsculas por casefold.
Não removemos acentos ou pontuação, não aproximamos grafias e não tentamos identificar marcas equivalentes. A regra também não reproduz necessariamente a busca da Anvisa. É uma segunda forma de agrupar os mesmos nomes conhecidos, útil para mostrar quanto o critério de igualdade altera o resultado.
| Critério | Chaves de nome conhecidas | Chaves compartilhadas | IDs confirmados em grupos compartilhados | % de todos os IDs |
|---|---|---|---|---|
| Texto literal — principal | 93.740 | 4.372 | 11.253 | 11,18% |
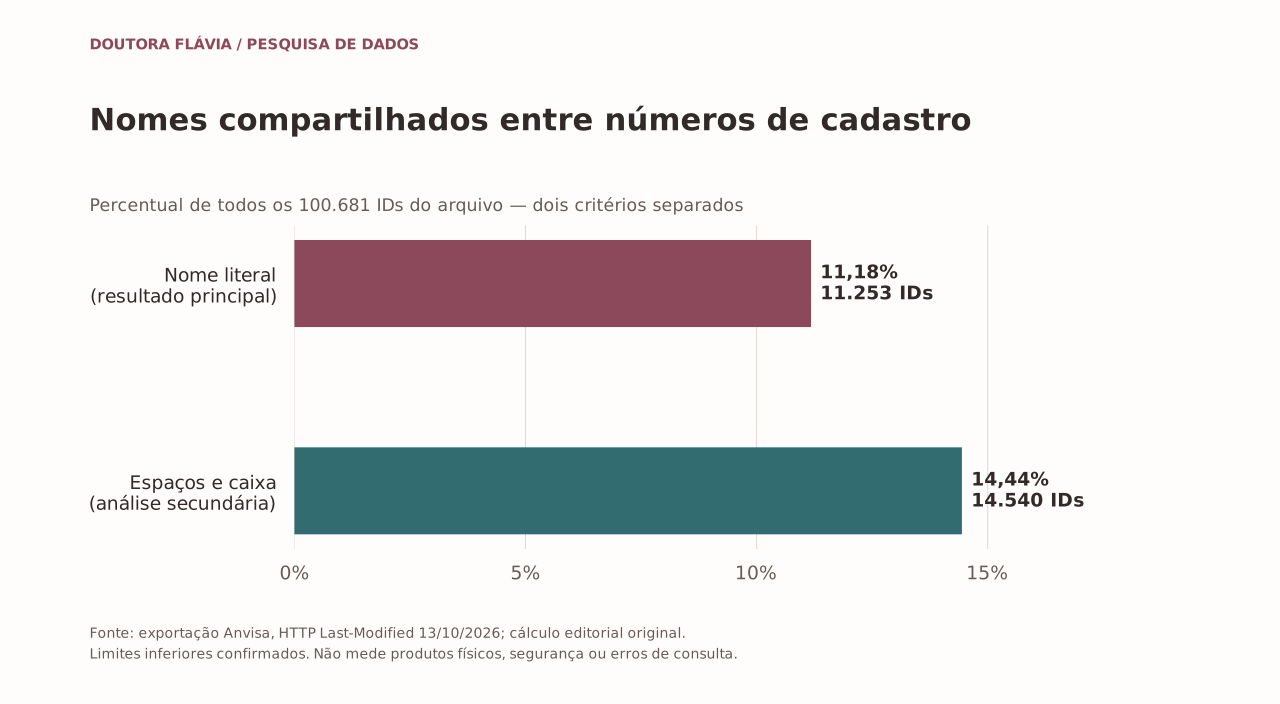
| NFC, espaços e caixa — secundário | 91.389 | 5.308 | 14.540 | 14,44% |
Com a segunda regra, 14.540 IDs participam de grupos compartilhados: 3.287 IDs a mais que no critério literal. Isso não significa 3.287 erros adicionais. Significa que uma definição menos sensível a variações de texto reúne mais identificadores. As quantidades de chaves também mudam; por isso, não descrevemos a diferença entre as contagens de nomes como uma lista de “novos nomes problemáticos”.

Adicionar o nome técnico resolve a identificação?
Não em todos os casos observados. Para responder de forma comparável, construímos uma única população de 100.572 associações completas, cada uma formada por ID + nome comercial + nome técnico. Recalculamos os grupos dentro dessa mesma população: primeiro com o nome comercial e depois com a combinação dos dois nomes.
O nome comercial literal sozinho era compartilhado em 11.246 dessas associações. A combinação literal de nome comercial e técnico continuava compartilhada em 9.813 associações, ou 9,76% do mesmo total. Em 1.433 associações, a chave combinada deixava de ser compartilhada. O valor inicial de 11.246 difere dos 11.253 do resultado geral porque aqui a população exige os dois nomes interpretáveis e os grupos foram recalculados nela.
| Critério dos textos | Chave comparada | Associações com chave compartilhada | % do mesmo total |
|---|---|---|---|
| Literal | Nome comercial | 11.246 | 11,18% |
| Literal | Comercial + técnico | 9.813 | 9,76% |
| Normalizado — secundário | Nome comercial | 14.531 | 14,45% |
| Normalizado — secundário | Comercial + técnico | 12.681 | 12,61% |


A unidade desta comparação é a associação completa, não uma afirmação de produto físico diferente. Neste arquivo, não encontramos mais de um nome comercial conhecido ou mais de um nome técnico conhecido para o mesmo ID. Mesmo assim, mantivemos a definição por associação no método: ela não depende de supor que todo cadastro futuro terá um único par de nomes.
Um exemplo inventado para entender a diferença
Considere o exemplo abaixo. Todos os textos e identificadores são fictícios; não são linhas da Anvisa nem nomes de produtos reais.
| Identificador fictício | Nome comercial inventado | Nome técnico inventado |
|---|---|---|
| ID A | Exemplo Alfa | Categoria X |
| ID B | Exemplo Alfa | Categoria X |
| ID C | Exemplo Alfa | Categoria Y |
O nome comercial é igual nos três IDs. Acrescentar o nome técnico separa o ID C, mas a combinação “Exemplo Alfa + Categoria X” ainda é compartilhada pelos IDs A e B. Nada nessa tabela informa quantos modelos existem, se algum item está disponível ou se houve erro administrativo. É apenas uma demonstração da chave de identificação.
Como essa informação pode ser útil
Para pacientes e familiares, o resultado ajuda a formular uma pergunta documental: qual é o número de registro ou cadastro associado ao dispositivo mencionado? O nome pode continuar sendo útil para conversar, mas não deve ser tratado como uma chave necessariamente exclusiva. Quando um número estiver disponível em documentação recebida, mantenha-o junto do nome e da identificação do modelo apresentada no documento, sem presumir que o número sozinho substitui os demais dados.
Para jornalistas, pesquisadores e equipes que organizam documentos, a implicação é semelhante: uma correspondência de nome não basta para juntar automaticamente duas informações como se fossem do mesmo item físico. Convém preservar os identificadores da fonte e descrever a unidade da comparação. Um cruzamento com dados de compras, notificações ou procedimentos exigiria regras e validação próprias; não foi realizado aqui.
A página oficial de consulta a registro de produtos da Anvisa apresenta o caminho para dispositivos médicos. Esta pesquisa não valida a disponibilidade do formulário, não executa consultas individuais e não substitui a informação atual da agência. Também não avalia se um dispositivo é indicado para uma pessoa ou procedimento.
A ligação com cirurgia plástica é a identificação de dispositivos mencionados em documentação e informações públicas. O estudo não filtrou o catálogo para estimar o mercado de implantes ou de cirurgia plástica. Dados de outras especialidades continuam no conjunto, e os percentuais não devem ser apresentados como estatísticas exclusivas de implantes mamários ou de pacientes de uma clínica.
Método, cobertura e reprodução
1. Uma fonte congelada, sem misturar edições
Utilizamos somente a exportação TA_PRODUTO_SAUDE_SITE.csv da Anvisa, obtida integralmente em 1º de novembro de 2026. O arquivo tinha 27.684.590 bytes e 116.008 linhas de dados, com 12 campos por linha. A impressão digital SHA-256 está no pacote metodológico. Uma execução com outra edição é interrompida, em vez de misturar números de versões diferentes.
O dicionário oficial de dezembro de 2020 explica que um número se repete quando há mais de um fabricante legal ou país de fabricação. Portanto, 116.008 linhas não significam 116.008 registros distintos, modelos ou dispositivos. Contamos os 100.681 textos distintos do campo de número de registro/cadastro, preservando zeros e comprimentos. Não impusemos uma regra de 11 dígitos: os IDs de 10 dígitos presentes na fonte também foram preservados.
2. Nomes desconhecidos permanecem desconhecidos
O dicionário indica separador ponto e vírgula e codificação 1252. Conferimos os limites dos 12 campos em todas as linhas. Uma verificação adicional com leitura estrita de CSV aceitou 116.007 linhas de dados com campos idênticos à separação por bytes; uma linha falhou e teve suas associações de nomes isoladas. O número de identificação dessa linha continuou no total de IDs.
Não adotamos uma regra permissiva para corrigir o arquivo. Excluímos dos agrupamentos qualquer nome comercial com aspas ASCII ou caracteres não decodificáveis estritamente em 1252. Foram 53 linhas com aspas, 17 com caracteres não interpretados e uma linha isolada pela leitura de CSV: 71 linhas, correspondentes a 60 IDs distintos. Para a comparação com nome técnico, a união das exclusões dos dois campos envolveu 109 IDs, restando 100.572 associações completas.
| Medida | Quantidade | Unidade e uso |
|---|---|---|
| Linhas de dados na exportação | 116.008 | Linhas administrativas; não são produtos distintos |
| Números distintos no arquivo | 100.681 | IDs; denominador geral |
| IDs com nome comercial interpretável | 100.621 | Também há 100.621 associações ID–nome conhecidas |
| IDs com algum nome comercial desconhecido | 60 | Permanecem no denominador geral |
| Associações completas interpretáveis | 100.572 | População fixa das comparações com nome técnico |
| IDs com algum dos dois nomes desconhecido | 109 | União das exclusões; não somar categorias sobrepostas |
Não havia nomes comerciais em branco entre os campos válidos nem IDs com múltiplos nomes conhecidos. Essas são constatações deste arquivo, não pressupostos aplicados para apagar conflitos. Campos corporativos, nomes de fabricantes, CNPJ, números e linhas de diagnóstico não são redistribuídos nos resultados.
3. Regras definidas e conferência independente
A pergunta e a normalização conservadora foram registradas antes dos cálculos. Após examinar o formato, documentamos uma alteração do método: o texto literal passou a ser o critério principal, a normalização permaneceu secundária e os casos de codificação ou aspas ficaram desconhecidos. Essa alteração antecedeu os resultados. Não se trata de um estudo pré-registrado.
Uma implementação independente refez os agrupamentos sem ler primeiro os resultados do programa principal. Foram conferidos os totais, os denominadores e as comparações. A especificação dos dois campos normalizados na comparação técnica foi esclarecida depois da primeira execução do produtor e antes da execução independente, preservando o comportamento já implementado. A população literal de associações completas não foi alterada nem deduplicada após normalizar.
4. Datas e situação regulatória têm limites próprios
O dicionário de 2020 descreve registros vigentes. Já o Plano de Dados Abertos 2022–2024, página 25, descreve válidos ou cancelados/caducos e menciona um campo de situação que não existe nas 12 colunas desta exportação. Não resolvemos essa divergência por suposição. A população é a dos IDs presentes no arquivo congelado, e não um censo certificado de autorizações atuais.
O campo de atualização contém literalmente “10/12/2026 19:00:00” nas 116.008 linhas. Como a ordem da data e o fuso não foram confirmados pelo dicionário, preservamos o texto sem convertê-lo para uma data ISO ou inferir um corte de observação. Ele é diferente do horário HTTP do arquivo e da data em que o obtivemos. Datas de publicação ou validade também não foram usadas para inventar uma classificação de “ativo”.
O que este estudo não permite concluir
- Não mede dispositivos físicos, modelos, vendas, implantes, cirurgias ou pacientes. O objeto é a relação entre nomes e números administrativos.
- Não verifica situação atual, disponibilidade ou segurança. Compartilhamento de nome não é evidência de irregularidade, falsificação ou risco clínico.
- Não mede confusão de pessoas ou desempenho de busca. Não observamos usuários, consultas, decisões ou erros.
- Não é exclusivo de cirurgia plástica. A população inclui diferentes tipos de dispositivos médicos presentes na fonte.
- Não trata ausência de compartilhamento como identificação física perfeita. Um registro pode abranger modelos; a fonte não é uma lista de unidades físicas.
- Não completa nomes desconhecidos. O percentual de nomes compartilhados vale para os nomes conhecidos; a parcela confirmada de todos os IDs é um limite inferior.
- Não é revisão médica nem orientação individual. É uma análise editorial de dados administrativos, com código e regras documentados.
Baixar os gráficos, conferir as contas e citar
Os arquivos abaixo contêm somente resultados agregados originais, gráficos e código próprio. O CSV integral da Anvisa, os identificadores, os nomes comerciais reais, os dados corporativos e as cópias dos documentos de referência não integram o pacote público.
- Tabela 1 — multiplicidade literal em CSV · Tabela 2 — critérios de texto em CSV.
- Tabela 3 — comparação técnica em CSV · Tabela 4 — cobertura em CSV.
- Resultados agregados em JSON e método, limites e instruções de reprodução.
- Código de cálculo próprio, alteração metodológica documentada e pacote completo de reutilização.
Para reproduzir o agrupamento completo é necessário obter separadamente o arquivo original com o mesmo SHA-256. A Anvisa pode substituir o conteúdo no endereço público; uma edição posterior não reproduz automaticamente este retrato. A cópia congelada foi preservada para auditoria, mas não é redistribuída. As tabelas agregadas permitem conferir as somas publicadas sem acessar linhas individuais.
Sugestão de citação: Equipe editorial de dados — Doutora Flávia. Quando o nome comercial não identifica um único cadastro na Anvisa. Análise secundária da exportação TA_PRODUTO_SAUDE_SITE.csv obtida em 1º de novembro de 2026, com 100.681 IDs. Ao usar o achado principal, informe: “11.253 IDs, ou 11,18% de todos os IDs do arquivo, associados a nomes comerciais literais compartilhados; limite inferior confirmado”.
Texto, tabelas agregadas e gráficos originais podem ser reutilizados sob CC BY 4.0, com crédito a esta análise e à Anvisa como fonte dos dados. O código próprio usa licença MIT. Essas licenças não abrangem a compilação original, documentos, marcas ou materiais de terceiros. Preserve os denominadores e os limites ao compartilhar.


Fontes primárias e escopo de cada uma
- Anvisa — exportação de produtos para saúde. Fonte exclusiva dos cálculos; arquivo congelado e verificado por SHA-256.
- Anvisa — documentação e dicionário, versão de dezembro de 2020. Significado dos campos, repetição por fabricante/país e descrição de formato; documento histórico.
- Anvisa — Plano de Dados Abertos 2022–2024. Documento histórico usado para explicitar a divergência de escopo, não para certificar situação atual.
- Anvisa — registro de produtos, pergunta 3. Distinção entre registro e família de modelos; não é uma revisão regulatória atual de cada item.
- Anvisa — perguntas e respostas sobre UDI, 17/02/2022, página 15. Exemplo oficial de que UDI-DI e registro não têm correspondência obrigatoriamente um a um.
- Anvisa — consulta a registro de produtos. Página oficial de orientação; formulário de dispositivos não validado por esta pesquisa.